Bạn vừa bỏ ra một khoản ngân sách không nhỏ để đầu tư thiết kế một trang web hoàn chỉnh, xuất bản hàng chục bài viết chuyên môn chất lượng, nhưng sau nhiều tuần tìm kiếm trên Google thì mọi dữ liệu vẫn hoàn toàn “mất tích”? Hoặc tai hại hơn, website của bạn từng đạt thứ hạng cao nhưng bỗng nhiên một ngày biến mất không dấu vết khỏi trang kết quả tìm kiếm? Rất có thể, thủ phạm đứng sau sự cố nghiêm trọng này chính là tệp tin robots.txt đang bị cấu hình sai lệch. Bạn đang tự hỏi robots.txt là gì và vì sao một tệp văn bản dung lượng chưa đầy 1KB lại có quyền năng chi phối toàn bộ khả năng xuất hiện của website trên Google?
Trong thế giới công nghệ web và Technical SEO, việc thấu hiểu tường tận robots.txt là gì được ví như việc bạn nắm trong tay tấm vé điều khiển cánh cổng an ninh bảo vệ tài nguyên máy chủ. Nếu cấu hình đúng, bạn sẽ định hướng Googlebot quét sâu vào những trang bán hàng trọng điểm, tiết kiệm tối đa ngân sách thu thập dữ liệu (Crawl Budget). Ngược lại, nếu không hiểu rõ robots.txt là gì, chỉ cần một dấu gạch chéo / đặt sai vị trí, bạn có thể vô tình “khóa cửa” toàn bộ website trước mặt mọi công cụ tìm kiếm trên thế giới.
Trong cẩm nang chuyên sâu này, các chuyên gia giải pháp công nghệ tại HATENA sẽ giúp bạn làm sáng tỏ robots.txt là gì, giải mã chi tiết các chỉ thị cú pháp kỹ thuật, phân biệt rạch ròi giữa robots.txt và thẻ Noindex, đồng thời hướng dẫn quy trình 5 bước khởi tạo, cấu hình và kiểm tra tệp robots.txt chuẩn SEO quốc tế mới nhất năm 2026.
1. Robots.txt là gì? Khái niệm, vị trí và nguyên lý điều hướng bot tìm kiếm
Để hiểu một cách trực quan robots.txt là gì, hãy tưởng tượng trang web của doanh nghiệp bạn giống như một tòa nhà văn phòng hiện đại. Trong tòa nhà đó, có những khu vực công cộng mở cửa đón chào mọi khách hàng (như sảnh lễ tân, showroom trưng bày sản phẩm, phòng tư vấn dịch vụ), nhưng cũng có những khu vực nội bộ hạn chế người ngoài (như phòng máy chủ, kho lưu trữ hồ sơ tài chính, phòng giám đốc).
Tệp tin robots.txt chính là một tấm biển chỉ dẫn đặt ngay tại cổng kiểm soát ra vào của tòa nhà. Khi các “nhân viên điều tra số” của công cụ tìm kiếm (chẳng hạn như Googlebot của Google, Bingbot của Microsoft) bước đến, họ sẽ nhìn vào tấm biển này đầu tiên để biết khu vực nào được phép bước vào khám phá, và khu vực nào bị nghiêm cấm tiếp cận.
Về mặt kỹ thuật, robots.txt là gì? Đây là một tệp văn bản thuần túy (plain text) được lưu dưới định dạng mã hóa UTF-8, tuân thủ theo tiêu chuẩn giao thức loại trừ robot (Robots Exclusion Protocol – REP) được khởi xướng từ năm 1994 và gần đây đã được tổ chức IETF chuẩn hóa chính thức theo tài liệu RFC 9309. Tệp này chứa các bộ quy tắc chỉ thị cho các trình thu thập dữ liệu web (crawlers/spiders) biết những đường dẫn URL nào trên website được phép hoặc không được phép gửi yêu cầu tải về. Thấu hiểu bản chất robots.txt là gì sẽ giúp quản trị viên chủ động quản lý lưu lượng truy cập từ bot một cách thông minh.
Vị trí bắt buộc của tệp robots.txt trên cấu trúc máy chủ
Một trong những nguyên tắc bất di bất dịch khi triển khai robots.txt là gì? Đó là tệp này bắt buộc phải nằm ở thư mục gốc (Root Directory) của tên miền cấp cao nhất (Domain) hoặc tên miền phụ (Subdomain). Các trình thu thập dữ liệu tự động chỉ quét tìm tệp robots.txt tại một địa chỉ URL duy nhất theo cấu trúc:
https://tenmien-cua-ban.vn/robots.txt
Những lưu ý sống còn về vị trí và tên gọi của file:
- Tên tệp phân biệt chữ hoa – chữ thường (Case-sensitive): Tên file bắt buộc phải viết toàn bộ bằng chữ thường là
robots.txt. Các tên gọi nhưRobots.TXT,Robots.txthayrobot.txtđều bị cỗ máy tìm kiếm coi là không tồn tại. - Không đặt trong thư mục con: Đường dẫn như
https://tenmien.vn/seo/robots.txtlà hoàn toàn vô giá trị. - Mã trạng thái HTTP trả về: Tệp robots.txt phải trả về mã trạng thái HTTP
200 OK. Nếu file trả về mã lỗi5xx(lỗi máy chủ), Googlebot sẽ tạm dừng thu thập dữ liệu toàn bộ website vì lo ngại làm sập server của bạn. - Mỗi subdomain cần một file riêng: Nếu bạn có các phân vùng độc lập như
blog.tenmien.vnhayshop.tenmien.vn, mỗi subdomain này bắt buộc phải có một tệp robots.txt riêng biệt.
Nguyên lý Googlebot tương tác với file robots.txt khi thu thập dữ liệu
Mỗi khi Googlebot chuẩn bị ghé thăm bất kỳ đường dẫn nào trên website của bạn, quy trình tự động sẽ diễn ra theo chuỗi logic nghiêm ngặt:
- Tải và đọc file robots.txt trước tiên: Trước khi tải bất kỳ trang HTML, hình ảnh hay mã kịch bản nào, Googlebot sẽ gửi yêu cầu HTTP GET đến địa chỉ
/robots.txt. - Lưu vào bộ nhớ đệm (Caching): Google thường lưu bản sao tệp robots.txt trong bộ nhớ cache khoảng 24 giờ. Nếu tệp của bạn có sự thay đổi đột xuất, bot có thể mất một khoảng thời gian ngắn để làm mới dữ liệu cache.
- So khớp các quy tắc chỉ thị: Bot đối chiếu tên định danh của nó (ví dụ
Googlebot) với các dòngUser-agenttrong file. Nó sẽ tìm nhóm quy tắc cụ thể nhất dành cho nó; nếu không có, nó sẽ tuân theo nhóm quy tắc chungUser-agent: *. - Quyết định gửi yêu cầu tải trang (Crawl) hoặc bỏ qua: Nếu URL bạn muốn bot đọc không bị chặn bởi lệnh
Disallow, bot sẽ tiếp tục gửi yêu cầu thu thập dữ liệu. Ngược lại, nếu đường dẫn nằm trong danh sách cấm, bot sẽ lập tức quay đầu và không tải tài nguyên của trang đó. Để trang web được lập chỉ mục thần tốc, bạn nên kết hợp cấu hình này với sitemap website và tham khảo cẩm nang cách đưa website lên Google nhanh nhất.
Nắm vững nguyên lý vận hành này chính là bước đệm then chốt khi tìm hiểu robots.txt là gì, đảm bảo doanh nghiệp không bao giờ đưa ra những chỉ thị gây hại cho sự hiện diện trực tuyến của mình.
2. Giải mã cú pháp kỹ thuật trong robots.txt: 5 chỉ thị bắt buộc phải nắm rõ
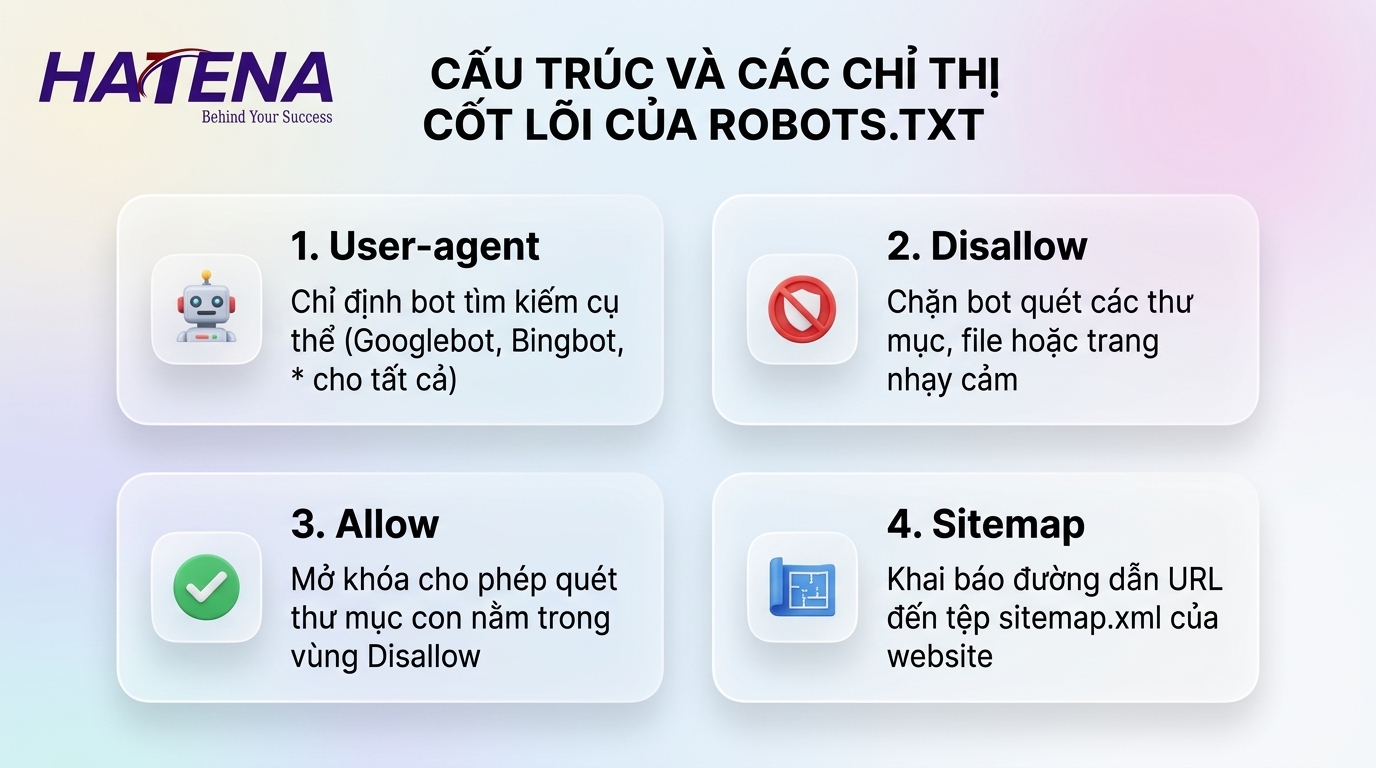
Cú pháp của tệp robots.txt tương đối đơn giản nhưng đòi hỏi sự chuẩn xác tuyệt đối. Một tệp chuẩn thường được cấu tạo từ các khối quy tắc (record), mỗi khối bắt đầu bằng một dòng định danh và theo sau là các chỉ thị hành động. Dưới đây là 5 thành phần cú pháp nền tảng bạn cần làm chủ khi nghiên cứu robots.txt là gì:
1. Chỉ thị User-agent (Chỉ định bot tìm kiếm áp dụng)
Dòng lệnh User-agent dùng để khai báo tên của trình thu thập dữ liệu mà các dòng lệnh tiếp theo sẽ áp dụng.
User-agent: *: Dấu sao (*) là ký tự đại diện áp dụng chung cho mọi bot tìm kiếm hợp lệ trên Internet (Google, Bing, Yahoo, Cốc Cốc…).User-agent: Googlebot: Chỉ thị chỉ áp dụng riêng cho bọ quét dữ liệu web chính của Google.User-agent: Googlebot-Image: Áp dụng riêng cho bọ thu thập hình ảnh của Google Hình ảnh.User-agent: Bingbot: Áp dụng riêng cho công cụ tìm kiếm Microsoft Bing.User-agent: GPTBot: Áp dụng cho bot cào dữ liệu huấn luyện AI của OpenAI.
2. Chỉ thị Disallow (Ngăn chặn thu thập dữ liệu)
Đây là chỉ thị quan trọng nhất để thông báo cho bot biết những URL nào không được phép thu thập dữ liệu. Đường dẫn trong lệnh Disallow phải được tính tương đối từ thư mục gốc của trang web:
Disallow: /admin/: Cấm bot quét toàn bộ thư mục quản trị và mọi trang con nằm bên trong/admin/.Disallow: /gio-hang/: Cấm bot truy cập trang giỏ hàng của website bán hàng để tránh lãng phí tài nguyên.Disallow: /tim-kiem?: Cấm bot cào các trang kết quả tìm kiếm nội bộ có chứa dấu chấm hỏi tham số.Disallow: /: CỰC KỲ NGUY HIỂM! Dấu gạch chéo đơn độc này mang ý nghĩa cấm bot quét TOÀN BỘ website từ trang chủ đến trang con.Disallow:: Để trống sau dấu hai chấm đồng nghĩa với việc KHÔNG CẤM bất kỳ trang nào (cho phép quét toàn bộ trang web).
3. Chỉ thị Allow (Cho phép thu thập dữ liệu ngoại lệ)
Chỉ thị Allow được các công cụ tìm kiếm hiện đại như Google và Bing hỗ trợ nhằm tạo ra các trường hợp ngoại lệ bên trong một thư mục đang bị cấm bởi Disallow.
Ví dụ kinh điển: Bạn muốn chặn toàn bộ thư mục tải lên /wp-content/uploads/, nhưng muốn cho phép bot đọc các tệp hình ảnh giới thiệu công ty nằm bên trong thư mục con /wp-content/uploads/gioi-thieu/:
User-agent: *
Disallow: /wp-content/uploads/
Allow: /wp-content/uploads/gioi-thieu/
Googlebot luôn ưu tiên quy tắc có độ dài chuỗi ký tự khớp cụ thể nhất. Trong trường hợp này, quy tắc Allow có đường dẫn dài và chi tiết hơn nên bot sẽ quét thư mục con mà vẫn chặn các phần còn lại.
4. Chỉ thị Sitemap (Khai báo vị trí sơ đồ trang web)
Chỉ thị Sitemap là cầu nối chiến lược giữa robots.txt và sơ đồ trang web XML. Mặc dù không bắt buộc, nhưng việc đặt liên kết sitemap trực tiếp vào file robots.txt là tiêu chuẩn vàng trong Technical SEO, giúp bất kỳ bot nào khi ghé thăm cũng ngay lập tức nhận được danh sách URL đầy đủ nhất:
Sitemap: https://hatena.vn/sitemap_index.xml
Lưu ý: Dòng Sitemap: bắt buộc phải sử dụng đường dẫn URL tuyệt đối có chứa đầy đủ giao thức https:// và có thể đặt ở bất kỳ vị trí nào trong file (thông thường được đặt ở dòng cuối cùng). Bạn có thể tìm hiểu thêm về tiêu chuẩn lập trình này tại trang thông tin chính thức Google Search Central về tổng quan robots.txt.
5. Ký tự đại diện khớp mẫu (Wildcards: * và $)
Googlebot và các công cụ tìm kiếm lớn công nhận hai ký tự đại diện mạnh mẽ giúp bạn tạo quy tắc linh hoạt:
- Dấu sao (
*): Đại diện cho bất kỳ chuỗi ký tự nào. Ví dụ, để chặn toàn bộ các tệp tài liệu PDF trên website, bạn chỉ cần viết:Disallow: /*.pdf$. - Dấu đô la (
$): Đánh dấu điểm kết thúc của một đường dẫn URL. Ví dụ,Disallow: /*.php$sẽ chặn các đường dẫn kết thúc bằng đuôi.php, nhưng không chặn URL có dạng/trang-chu.php?id=123.
Mẫu file robots.txt chuẩn hoàn chỉnh cho website WordPress và doanh nghiệp
Dưới đây là cấu hình mẫu lý tưởng, an toàn 100% được đội ngũ kỹ sư phần mềm HATENA tối ưu sẵn cho các hệ thống website chuẩn mực:
# Mẫu file robots.txt tối ưu chuẩn SEO bởi CÔNG TY TNHH CÔNG NGHỆ PHẦN MỀM HATENA
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /tim-kiem?
Disallow: /*?add-to-cart=*

# Cho phép bot truy cập tài nguyên giao diện để render trang chính xác
Allow: /*.css$
Allow: /*.js$

# Khai báo sơ đồ trang web chính quy
Sitemap: https://hatena.vn/sitemap_index.xml
Hiểu rõ cấu trúc mẫu này khi tìm hiểu robots.txt là gì sẽ giúp bạn tự tin rà soát website của mình, loại bỏ ngay các quy tắc rườm rà gây xung đột.
3. Phân biệt robots.txt là gì và thẻ Noindex: Tránh nhầm lẫn tai hại trong Technical SEO
Một trong những sai lầm phổ biến nhất của các lập trình viên mới vào nghề và chủ doanh nghiệp khi tìm hiểu robots.txt là gì chính là sự nhầm lẫn giữa hai khái niệm: Ngăn chặn thu thập dữ liệu (Block Crawling) và Ngăn chặn lập chỉ mục (Block Indexing).
Nhiều người lầm tưởng rằng: “Cứ thêm URL vào file robots.txt với lệnh Disallow là trang đó sẽ không bao giờ xuất hiện trên kết quả tìm kiếm Google!”. Đây là một quan niệm hoàn toàn sai lầm và có thể dẫn đến những hệ lụy khôn lường về bảo mật dữ liệu.
Bản chất khác biệt giữa Robots.txt và Thẻ Noindex
Google đã phân định ranh giới kỹ thuật rất rõ ràng giữa hai công cụ này:
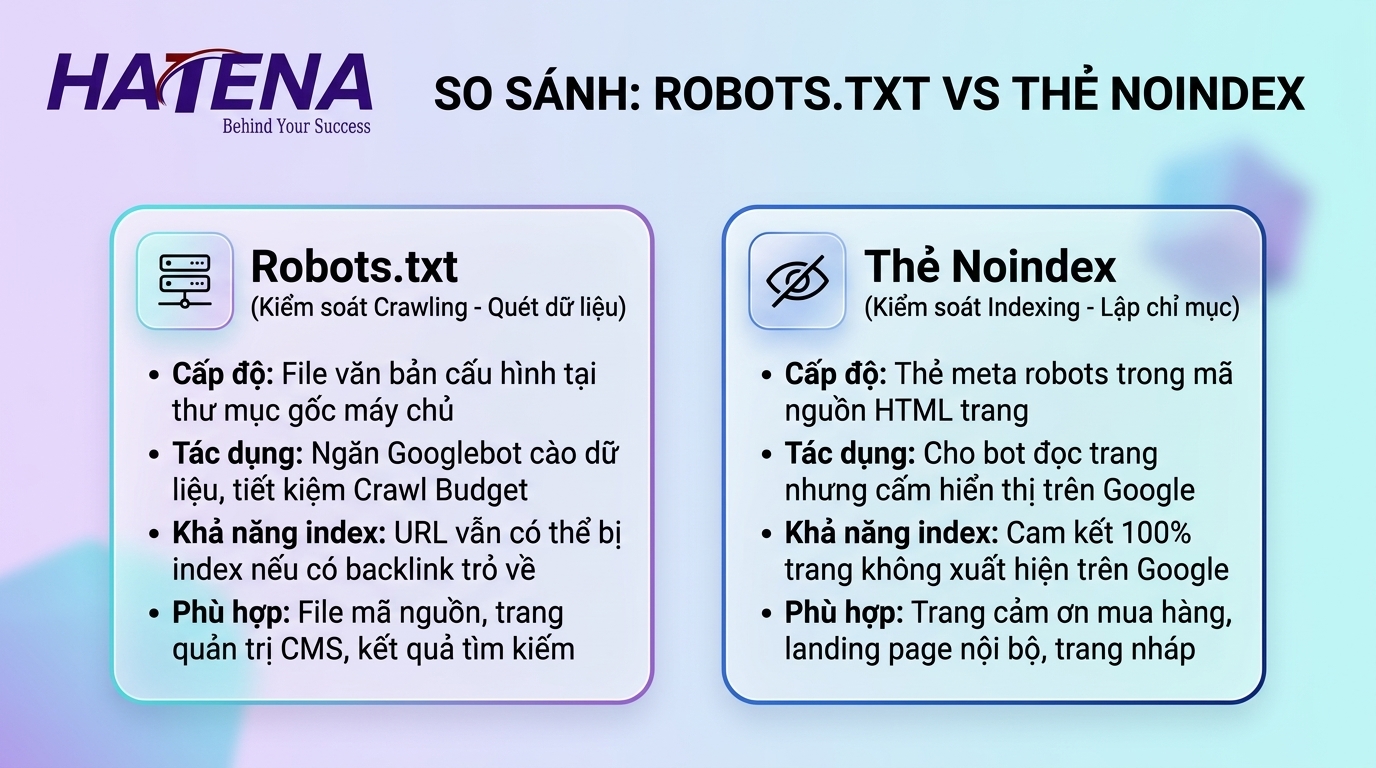
- Robots.txt kiểm soát việc THU THẬP DỮ LIỆU (Crawling): Nó chỉ có tác dụng yêu cầu Googlebot không tải mã HTML và dữ liệu của trang đó về máy chủ Google. Tuy nhiên, nếu URL đó được liên kết từ các trang web khác (backlink) hoặc liên kết nội bộ, Googlebot vẫn biết đến sự tồn tại của đường dẫn đó. Khi đó, Google vẫn có thể đưa URL này lên bảng kết quả tìm kiếm kèm theo dòng thông báo: “Không có thông tin cho trang này do tệp robots.txt”.
- Thẻ Noindex kiểm soát việc LẬP CHỈ MỤC (Indexing): Khi bạn gắn thẻ
<meta name="robots" content="noindex">vào phần<head>của trang HTML, bạn cho phép Googlebot ghé thăm và đọc trang, nhưng gửi mệnh lệnh đanh thép: “Không được lưu trang này vào kho dữ liệu tìm kiếm!”. Đây là cách duy nhất đảm bảo 100% trang web sẽ biến mất hoàn toàn khỏi kết quả tìm kiếm.
Bảng so sánh đối chiếu toàn diện giữa Robots.txt và Thẻ Noindex
| Tiêu chí so sánh | Tệp tin Robots.txt | Thẻ Meta Robots (Noindex) |
|---|---|---|
| Vị trí triển khai | Đặt tập trung tại thư mục gốc của máy chủ (/robots.txt). |
Đặt phân tán trong mã nguồn <head> của từng trang web cụ thể. |
| Mục tiêu cốt lõi | Tiết kiệm băng thông máy chủ và tối ưu ngân sách thu thập dữ liệu (Crawl Budget). | Ngăn chặn triệt để URL xuất hiện trên bảng xếp hạng tìm kiếm Google. |
| Googlebot có đọc trang không? | KHÔNG: Bot bị chặn ngay từ ngoài cửa, không tải mã nguồn trang. | CÓ: Bot phải tải và đọc mã nguồn thì mới thấy lệnh noindex để thực thi. |
| Khả năng ngăn Index | Không đảm bảo: Trang vẫn có thể bị index nếu có liên kết ngoài trỏ về. | Đảm bảo 100%: Trang chắc chắn bị loại bỏ khỏi chỉ mục của Google. |
| Trường hợp áp dụng lý tưởng | Các tệp mã nguồn quản trị, trang lọc đa tiêu chí, file rác hệ thống, tệp hình ảnh không cần index. | Trang cảm ơn sau mua hàng (Thank you page), trang nội dung khuyến mãi riêng tư, landing page chạy quảng cáo độc quyền. |
Cảnh báo kỹ thuật tối quan trọng: Tuyệt đối không áp dụng cả Disallow trong robots.txt và thẻ Noindex trên cùng một trang! Nếu bạn chặn trang trong robots.txt, Googlebot sẽ không thể truy cập vào trang để đọc mã HTML. Kết quả là nó sẽ không bao giờ nhìn thấy thẻ `noindex` của bạn, và trang web vẫn tiếp tục hiển thị trên Google. Do đó, việc hiểu cặn kẽ robots.txt là gì sẽ giúp bạn tránh được cái bẫy kỹ thuật vô cùng tai hại này.
4. Vì sao website doanh nghiệp bắt buộc phải tối ưu hóa file robots.txt?
Nhiều chủ doanh nghiệp cho rằng tệp robots.txt chỉ là chuyện nhỏ nhặt của dân công nghệ. Nhưng trên thực tế khi hiểu sâu robots.txt là gì, bạn sẽ nhận ra tệp tin nhỏ bé này lại nắm giữ chiếc chìa khóa tác động trực tiếp đến hiệu quả kinh doanh và dòng tiền doanh nghiệp thông qua 4 lợi ích chiến lược:
1. Tối ưu hóa ngân sách thu thập dữ liệu (Crawl Budget)
Googlebot không sở hữu tài nguyên vô hạn. Với mỗi trang web, Google chỉ cấp một hạn mức thu thập dữ liệu nhất định trong một ngày (gọi là Crawl Budget). Hạn mức này phụ thuộc vào độ uy tín của tên miền, tốc độ phản hồi của máy chủ và quy mô website.
Nếu website bán hàng của bạn có 5.000 sản phẩm nhưng lại sinh ra 50.000 trang lọc URL rác (như sắp xếp theo giá, màu sắc, kích thước, phân trang lặp), Googlebot sẽ dành phần lớn thời gian trong ngày để cào những trang vô nghĩa đó. Hậu quả là các sản phẩm mới ra mắt hoặc bài viết dịch vụ sinh lời cao bị “bỏ quên”, không kịp lập chỉ mục. Khi hiểu sâu robots.txt là gì, bạn sẽ dùng lệnh Disallow để phong tỏa toàn bộ các URL rác, ép Googlebot dồn 100% sức mạnh vào những trang chuyển đổi doanh thu cốt lõi.
2. Giảm tải áp lực máy chủ và bảo vệ băng thông Hosting/VPS
Một website thương mại điện tử hoặc cổng thông tin doanh nghiệp lớn thường xuyên phải đối mặt với hàng chục đợt cào dữ liệu từ các công cụ phân tích đối thủ (như Ahrefs, SEMrush) hoặc các bot thu thập dữ liệu trí tuệ nhân tạo.
Nếu không có sự can thiệp của tệp robots.txt, hàng trăm nghìn yêu cầu cào dữ liệu cùng lúc có thể làm tê liệt cơ sở dữ liệu MySQL, khiến máy chủ bị quá tải (lỗi 503 Service Unavailable) và làm website của bạn tải chậm như rùa trước mắt khách hàng thật. Việc khai báo robots.txt là gì đúng cách cho phép bạn ngăn chặn các bot độc hại, giữ cho hạ tầng máy chủ luôn vận hành ổn định và mượt mà.
3. Ngăn ngừa lỗi trùng lặp nội dung (Duplicate Content)
Các hệ thống quản trị nội dung CMS thường tự động sinh ra các biến thể đường dẫn cho cùng một nội dung (ví dụ phiên bản in /print/, phiên bản phân trang tham số ?page=2, trang tag bài viết).
Nếu để Googlebot tự do thu thập tất cả, các trang web này sẽ tự ăn thịt từ khóa lẫn nhau (Keyword Cannibalization), làm loãng tín hiệu SEO của trang chính. Sử dụng robots.txt là giải pháp tuyến đầu giúp dọn sạch đường đi cho cỗ máy tìm kiếm, bổ trợ đắc lực cho chiến dịch tối ưu content SEO dài hạn của doanh nghiệp.
4. Điều hướng Googlebot ưu tiên tài nguyên quan trọng
Bằng cách kết hợp linh hoạt giữa các chỉ thị Allow, Disallow và Sitemap, bạn chủ động kiến tạo một luồng giao thông số hoàn hảo. Googlebot sẽ di chuyển trơn tru từ trang chủ, qua danh mục dịch vụ, đến các bài viết kiến thức chuyên sâu và chuyển đổi mà không gặp bất kỳ vật cản vô lý nào. Điều này lý giải tại sao mọi quy chuẩn phát triển tại dịch vụ thiết kế website doanh nghiệp của HATENA luôn coi robots.txt là hạng mục kiểm tra chất lượng bắt buộc trước khi bàn giao.
5. Quy trình 5 bước tạo, cấu hình và kiểm tra robots.txt chuẩn SEO từ A–Z
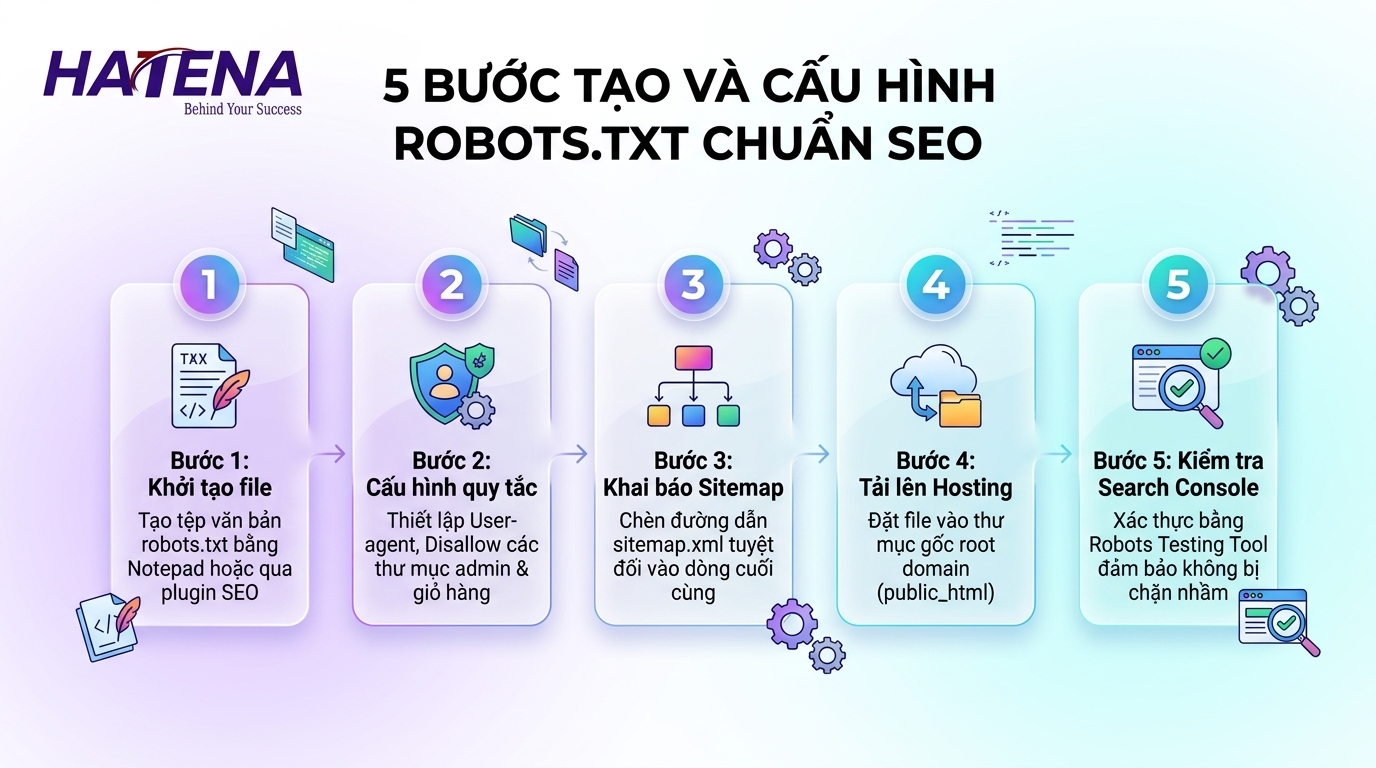
Để giúp bạn dễ dàng tự tay thiết lập một tệp tin hoàn hảo cho website của mình mà không cần phụ thuộc vào lập trình viên, việc thực hành nắm rõ robots.txt là gì qua quy trình 5 bước tiêu chuẩn công nghệ quốc tế sau đây là vô cùng cần thiết:
Bước 1: Khởi tạo tệp văn bản thô robots.txt
Trong bước đầu tiên khi học cách cấu hình robots.txt là gì, bạn có thể tạo tệp theo một trong hai cách rất đơn giản:
- Cách 1 (Phương pháp thủ công an toàn nhất): Mở ứng dụng Notepad (trên Windows) hoặc TextEdit (trên macOS). Tạo một tài liệu mới hoàn toàn trống rỗng, sau đó lưu lại với tên chính xác là
robots.txtvới bảng mã định dạng làUTF-8(tuyệt đối không dùng Microsoft Word vì Word sẽ chèn các ký tự ẩn gây lỗi bot). - Cách 2 (Sử dụng plugin SEO trên WordPress): Nếu bạn đang sử dụng plugin Rank Math SEO hoặc Yoast SEO, bạn chỉ cần vào menu Rank Math > General Settings > Edit robots.txt. Plugin sẽ cho phép bạn chỉnh sửa tệp robots.txt trực tiếp ngay trên giao diện quản trị mà không cần mở máy chủ.
Bước 2: Thiết lập các quy tắc User-agent và Disallow phù hợp với cấu trúc website
Dựa vào nền tảng công nghệ mà website của bạn đang sử dụng, hãy thêm các khối lệnh tương ứng. Ví dụ đối với website giới thiệu công ty hoặc bán hàng thông dụng, bạn hãy nhập các quy tắc cơ bản:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /readme.html
Disallow: /license.txt
Khối lệnh trên đảm bảo khóa chặt các tệp thông tin phiên bản mã nguồn để tránh hacker soi lỗ hổng, nhưng vẫn mở quyền cho tệp admin-ajax.php hoạt động bình thường nhằm phục vụ các tính năng tải trang không giật lag. Hiểu rõ từng dòng lệnh trong robots.txt là gì sẽ giúp bạn làm chủ 100% an ninh trang web.
Bước 3: Khai báo liên kết Sitemap XML ở dòng cuối cùng
Đừng bao giờ quên khai báo sơ đồ trang web! Hãy copy chính xác đường dẫn sitemap chính của website bạn và thêm vào cuối tệp:
Sitemap: https://tenmien-cua-ban.vn/sitemap_index.xml
Nếu website của bạn có nhiều sitemap con chuyên biệt (ví dụ sitemap tin tức, sitemap sản phẩm), bạn có thể liệt kê nhiều dòng Sitemap: liên tiếp nhau.
Bước 4: Tải tệp robots.txt lên thư mục gốc (public_html) của Hosting/VPS
Sau khi đã hiểu bản chất robots.txt là gì và hoàn thiện nội dung file, bạn cần đẩy tệp lên thư mục gốc của máy chủ hosting:
- Mở trình quản lý tệp (File Manager).
- Truy cập vào thư mục gốc chứa mã nguồn website (thường mang tên
public_htmlhoặcwwwhoặc thư mục tên miền của bạn). - Tải tệp
robots.txtvừa tạo lên thư mục này. - Mở trình duyệt web và gõ
https://tenmien-cua-ban.vn/robots.txtđể kiểm tra. Nếu nội dung văn bản hiển thị rõ ràng trên màn hình, bạn đã tải lên thành công!
Bước 5: Kiểm tra và xác thực quy tắc bằng Google Search Console
Sau khi tệp đã xuất hiện trên máy chủ, bước cuối cùng là xác minh xem Googlebot có đọc hiểu chính xác các chỉ thị của bạn hay không:
- Truy cập vào công cụ Robots Testing Tool chính thức của Google (hoặc mở báo cáo Robots.txt mới trong Google Search Console).
- Nhập các đường dẫn quan trọng (như URL bài viết, URL trang chủ, URL trang dịch vụ) để kiểm tra xem có bị dán nhãn “Blocked” (Đã bị chặn) vô lý hay không.
- Nếu công cụ báo kết quả màu xanh “Allowed” (Được phép), xin chúc mừng, bạn đã cấu hình hoàn tất một tệp robots.txt chuẩn Technical SEO đẳng cấp!
Việc tuân thủ 5 bước chuẩn hóa này sẽ giải quyết dứt điểm nỗi lo lắng về việc tại sao vì sao website mới làm xong nhưng Google chưa index, tạo bước đệm hoàn hảo để website xuất hiện trên trang nhất.
6. 5 sai lầm tai hại khi cấu hình robots.txt khiến website bị Google đánh rớt hạng
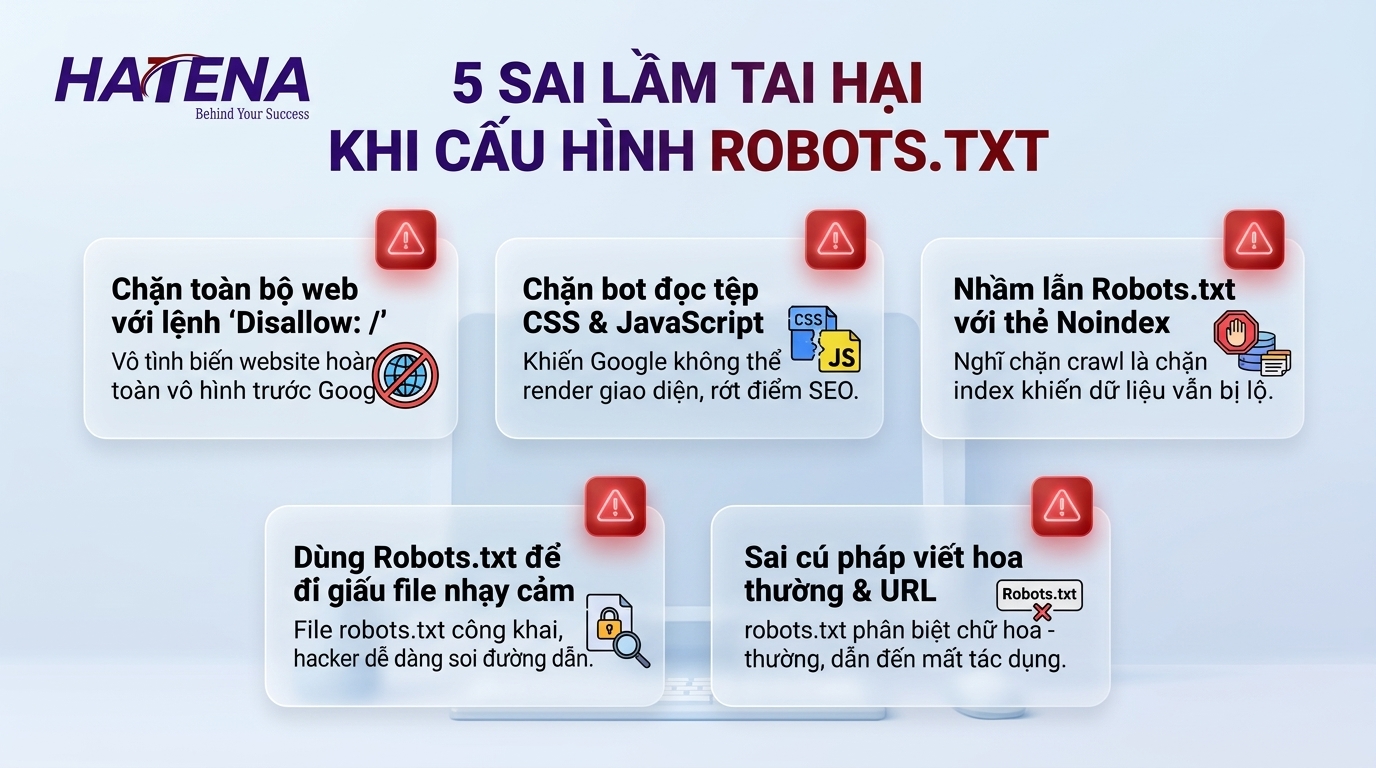
Robots.txt là một con dao hai lưỡi. Với sự sắc bén của mình, chỉ một sơ suất nhỏ cũng có thể làm bốc hơi toàn bộ lưu lượng truy cập tìm kiếm của công ty. Dưới đây là 5 sai lầm tai hại kinh điển mà các kỹ sư HATENA đã trực tiếp giải cứu cho hàng loạt doanh nghiệp:
Sai lầm 1: Vô tình để lệnh Disallow: / sau khi nghiệm thu website chạy thử (Staging)
Đây là “tai nạn nghề nghiệp” phổ biến nhất trong giới thiết kế web. Khi xây dựng website trên môi trường chạy thử (demo/staging), các lập trình viên thường bật tính năng “Ngăn chặn các công cụ tìm kiếm lập chỉ mục trang web này” để tránh bị Google phạt lỗi trùng lặp nội dung. Hành động này sẽ tự động sinh ra một lệnh tử thần trong robots.txt:
User-agent: *
Disallow: /
Dấu gạch chéo / ở đây có nghĩa là: CẤM TOÀN BỘ WEBSITE. Khi bàn giao sang tên miền chính thức, nhiều đơn vị làm web thiếu chuyên nghiệp đã quên không gỡ bỏ lệnh này. Hệ quả là website chạy suốt 3 tháng liền nhưng không một bài viết nào xuất hiện trên Google, gây thiệt hại nghiêm trọng về doanh số kinh doanh. Do đó, kiểm tra lệnh cấm này là bài học vỡ lòng khi nghiên cứu robots.txt là gì.
Sai lầm 2: Chặn Googlebot đọc các tệp tài nguyên CSS và JavaScript
Sai lầm nghiêm trọng này thường xuất phát từ việc hiểu sai robots.txt là gì trong thời kỳ SEO hiện đại. Nhiều năm trước, một số người khuyên nên chặn thư mục chứa CSS và JS để tiết kiệm băng thông. Tuy nhiên, kể từ khi Google chuyển sang cơ chế thu thập dữ liệu bằng trình duyệt Chrome headless hiện đại, Google cần phải tải toàn bộ CSS và JavaScript thì mới có thể “nhìn thấy” giao diện website giống hệt như một người dùng thật trên màn hình điện thoại di động.
Nếu bạn viết Disallow: /wp-content/themes/ hoặc chặn các file .js, Googlebot sẽ không thể render được bố cục trang, dẫn đến việc hiểu sai nội dung, đánh rớt điểm trải nghiệm trang (Page Experience) và phạt tụt hạng nghiêm trọng trên kết quả tìm kiếm di động.
Sai lầm 3: Nhầm lẫn giữa việc chặn quét (Robots.txt) và xóa URL khỏi Google (Noindex)
Nhiều quản trị viên khi muốn loại bỏ một trang bài viết cũ hoặc một trang danh mục lỗi thời liền vội vàng thêm URL đó vào file robots.txt với hy vọng Google sẽ xóa nó đi. Nhưng như đã phân tích ở phần so sánh robots.txt là gì, việc chặn bot ghé thăm sẽ ngăn cản Google cập nhật trạng thái mới của trang. URL lỗi đó sẽ tiếp tục “sống dai dẳng” trên kết quả tìm kiếm Google hàng tháng trời mà không thể biến mất.
Giải pháp đúng đắn: Hãy gắn thẻ noindex trước, đợi Googlebot ghé thăm và xóa URL khỏi chỉ mục tìm kiếm, sau đó mới quyết định có cần chặn trong robots.txt hay không.
Sai lầm 4: Sử dụng robots.txt để cố gắng che giấu dữ liệu bảo mật, nhạy cảm
Nhiều người nghĩ rằng: “Mình sẽ cho đường dẫn tài liệu mật vào Disallow để không ai tìm thấy!”. Đây là một tư duy an ninh mạng cực kỳ ngây thơ!
Hãy nhớ rằng: Tệp tin robots.txt là một tệp công khai 100% trên toàn cầu. Bất kỳ ai, từ người dùng thông thường cho đến hacker chuyên nghiệp, chỉ cần gõ tenmien.com/robots.txt là có thể đọc trọn vẹn toàn bộ danh sách các thư mục mà bạn đang cố gắng giấu diếm. Nếu bạn có các trang quản trị đặc biệt hoặc tài liệu nội bộ, hãy bảo vệ chúng bằng hệ thống xác thực mật khẩu nhiều lớp (Authentication), phân quyền IP truy cập hoặc cấu hình bảo mật tầng máy chủ .htaccess, tuyệt đối không dùng robots.txt làm công cụ bảo mật!
Sai lầm 5: Sai cú pháp viết hoa thường hoặc thiếu dấu gạch chéo đóng mở
Quy tắc so khớp của robots.txt cực kỳ nhạy cảm:
Disallow: /adminsẽ chặn cả đường dẫn/admin/,/admin-login.html, và cả trang/administrator/. Nếu bạn chỉ muốn chặn riêng thư mục admin, bạn bắt buộc phải có dấu gạch chéo kết thúc:Disallow: /admin/.- Robots.txt phân biệt rạch ròi chữ hoa và chữ thường:
Disallow: /Product/sẽ không có tác dụng gì nếu đường dẫn thực tế trên web của bạn là/product/.
Tránh được 5 cạm bẫy kể trên chính là minh chứng rõ nét cho việc bạn đã thực sự thấu hiểu tường tận robots.txt là gì và biết cách vận hành một cỗ máy số chuẩn mực.
7. HATENA – Đơn vị thiết kế website chuẩn Technical SEO, cấu hình robots.txt tối ưu toàn diện
Một trang web thành công không chỉ cần một tấm áo giao diện bóng bẩy, lộng lẫy bên ngoài mà cốt lõi phải sở hữu một bộ khung kỹ thuật vững chắc, mạch lạc bên trong. Nếu bạn đang tìm kiếm một đối tác công nghệ có năng lực thực chiến, am hiểu sâu sắc về kiến trúc công cụ tìm kiếm và không bao giờ để xảy ra những sai sót kỹ thuật sơ đẳng như việc cấu hình sai robots.txt là gì, CÔNG TY TNHH CÔNG NGHỆ PHẦN MỀM HATENA chính là điểm tựa số vững chắc nhất của doanh nghiệp bạn:
- Chuẩn hóa Technical SEO từ từng dòng code đầu tiên: Chúng tôi kiên quyết nói không với mã nguồn rác sao chép giá rẻ. Mọi dự án do HATENA thiết kế đều được quy hoạch cấu trúc phân cấp Silo logic, tự động sinh tệp sitemap XML thời gian thực, cấu hình tệp robots.txt chuẩn chỉ từng dấu gạch chéo, khai báo Schema Entity doanh nghiệp chính thống giúp cỗ máy tìm kiếm định danh thương hiệu ngay trong tuần đầu tiên ra mắt. Bạn có thể tham khảo thêm góc nhìn đa chiều tại bài viết thiết kế website chuẩn SEO là gì.
- Thiết kế giao diện UI/UX độc quyền – Đo ni đóng giày cho thương hiệu: Không nhân bản giao diện đại trà, từng màn hình được các chuyên gia thiết kế tỉ mỉ 100% trên Figma theo bản sắc riêng biệt của ngành nghề, tối ưu hóa tỷ lệ chuyển đổi khách hàng tiềm năng cao nhất. Tìm hiểu chi tiết tại dịch vụ thiết kế website doanh nghiệp của chúng tôi.
- Tốc độ tải trang siêu tốc chuẩn Google Core Web Vitals: Cam kết tốc độ tải trang dưới 1.5 giây, đạt điểm số Google PageSpeed xanh 85–95+, tối ưu hóa toàn diện tài nguyên hình ảnh định dạng WebP thế hệ mới, giúp Googlebot thu thập dữ liệu mượt mà mà không làm tốn tài nguyên máy chủ.
- Bàn giao 100% tài sản số và minh bạch chi phí: Doanh nghiệp nắm quyền sở hữu tối cao đối với toàn bộ mã nguồn sạch, tài khoản quản trị máy chủ hosting và tài khoản Google Search Console chính chủ. Bạn có thể tham khảo bài phân tích chi tiết về chi phí thiết kế website, góc nhìn so sánh sâu sắc website 3 triệu, 10 triệu và 30 triệu khác nhau ở đâu hay phân tích chiến lược nên thuê freelancer hay công ty thiết kế website để có sự lựa chọn đối tác sáng suốt nhất cho doanh nghiệp mình.
- Bảo hành bảo trì trọn đời – Đội ngũ kỹ sư hỗ trợ 24/7: Chúng tôi thiết lập cơ chế sao lưu dữ liệu tự động định kỳ hàng tuần lên đám mây, túc trực giám sát an ninh mạng và cam kết đồng hành giải quyết mọi khúc mắc kỹ thuật trong suốt vòng đời vận hành của website. Khám phá toàn diện năng lực của chúng tôi tại trang chủ dịch vụ thiết kế website HATENA.
8. Kết luận: Làm chủ robots.txt là gì để khai thông sức mạnh hiển thị trên Google
Tóm lại, robots.txt là gì không còn là câu hỏi kỹ thuật đơn thuần, mà là một công cụ quản trị chiến lược bảo vệ toàn diện tài sản số của doanh nghiệp bạn trên Internet.
Một trang web dù có mức đầu tư hàng chục triệu đồng, hình ảnh lung linh bắt mắt đến đâu nhưng nếu bị “khóa cửa” bởi một dòng lệnh sai trong file robots.txt thì cũng giống như một cửa hàng bề thế tọa lạc nơi ngõ cụt không một bóng người qua lại. Bằng việc thấu hiểu tường tận robots.txt là gì, phân biệt chính xác với thẻ Noindex, nắm vững 5 chỉ thị cú pháp nền tảng và kiểm soát chặt chẽ 5 sai lầm tai hại thường gặp, bạn đã khai thông con đường huyết mạch để Googlebot lập chỉ mục toàn bộ tài nguyên số của doanh nghiệp nhanh chóng, an toàn và bền vững nhất.
Đừng để những bài viết tâm huyết và sản phẩm giá trị của bạn bị chìm vào góc khuất vô hình do chưa làm chủ robots.txt là gì. Hãy chủ động rà soát lại tệp tin điều hướng của website mình ngay hôm nay để đón đầu hàng ngàn lượt khách hàng tiềm năng mỗi ngày từ cỗ máy tìm kiếm lớn nhất thế giới!
Nếu quý khách hàng đang cần kiểm toán tổng thể sức khỏe Technical SEO website hoặc mong muốn sở hữu một hệ thống website doanh nghiệp chuẩn SEO bứt phá doanh thu, hãy liên hệ ngay với đội ngũ chuyên gia công nghệ tại HATENA để được tư vấn chuyên sâu và nhận lộ trình triển khai tối ưu nhất!
Liên hệ HATENA để được tư vấn robots.txt và tối ưu website
CÔNG TY TNHH CÔNG NGHỆ PHẦN MỀM HATENA
📞 Hotline: 0934 217 611
📧 Email: hatenasolution@gmail.com
📍 Địa chỉ: Tầng 15, Khối A Tòa nhà Sông Đà, đường Phạm Hùng, Phường Từ Liêm, Thành phố Hà Nội, Việt Nam
HATENA – Đồng hành cùng doanh nghiệp trên hành trình xây dựng và phát triển hệ thống công nghệ số.