Lượt truy cập tăng đột biến thường khiến doanh nghiệp kỳ vọng chiến dịch SEO hoặc nội dung mới đang tạo kết quả. Nhưng nếu phần lớn lượt đó đến từ crawler, công cụ quét tự động hoặc bot giả dạng người dùng, báo cáo traffic, thời gian tương tác và chuyển đổi có thể bị đọc sai. Ngược lại, chặn nhầm bot tìm kiếm hợp lệ có thể cản trở việc thu thập dữ liệu của website.
Vì vậy, khi thấy traffic từ bot AI tăng bất thường, đừng vội chặn mọi địa chỉ lạ hoặc kết luận rằng doanh nghiệp đang được AI trích dẫn. Hãy xác định nguồn request, mục đích truy cập, dấu vết trong analytics và ảnh hưởng thực tế đến hệ thống trước khi thay đổi cấu hình.
Trước tiên, phân biệt ba nhóm truy cập
1. Bot tìm kiếm
Bot tìm kiếm thu thập trang để lập chỉ mục hoặc phục vụ một tính năng tìm kiếm. Googlebot và Bingbot là ví dụ quen thuộc. Chúng thường truy cập nhiều URL, gồm trang bài viết, danh mục, ảnh hoặc sitemap; có thể xuất hiện trong log máy chủ dù không tạo phiên truy cập trong GA4.
Đừng xác minh crawler chỉ bằng tên User-Agent. Header này có thể bị giả mạo. Google hướng dẫn xác thực Googlebot bằng reverse DNS từ IP nguồn, sau đó tra DNS xuôi để bảo đảm hostname trả về đúng IP ban đầu, hoặc đối chiếu IP với danh sách dải IP crawler chính thức. Cách này giúp tránh chặn nhầm bot tìm kiếm hợp lệ.
2. Bot AI và công cụ tự động
“Bot AI” không phải một nhóm duy nhất. Một số crawler thu thập nội dung để phục vụ tìm kiếm hoặc câu trả lời; một số công cụ truy cập URL khi người dùng yêu cầu tóm tắt; một số agent có thể duyệt website để thực hiện tác vụ. Động cơ và cách truy cập của chúng khác nhau, vì vậy một nhãn “AI” trong User-Agent chưa cho biết đầy đủ request có hợp lệ, có được chủ website cho phép hay có gây tải đáng kể hay không.
Các crawler công khai thường tự nhận diện bằng User-Agent riêng và một số nhà cung cấp công bố dải IP hoặc cách xác thực. Tuy nhiên, danh sách bot thay đổi theo thời gian. Khi cần xác minh một bot cụ thể, hãy tra tài liệu chính thức của đơn vị vận hành và đối chiếu IP, hostname, nhịp request cùng đường dẫn bị truy cập. Đừng áp dụng danh sách cũ như quy tắc cố định.
3. Truy cập của khách hàng thật
Khách hàng thật thường tạo chuỗi hành động có ngữ cảnh: vào trang đích, mở trang dịch vụ, xem thông tin liên hệ, gửi biểu mẫu hoặc quay lại sau đó. Họ có thể dùng mạng công ty, VPN, trình duyệt riêng tư hoặc thiết bị chặn cookie, nên một số lượt thật vẫn thiếu thông tin địa lý, referrer hoặc cookie. Một dấu hiệu đơn lẻ như thời gian trên trang thấp hay quốc gia lạ không đủ để kết luận đó là bot.
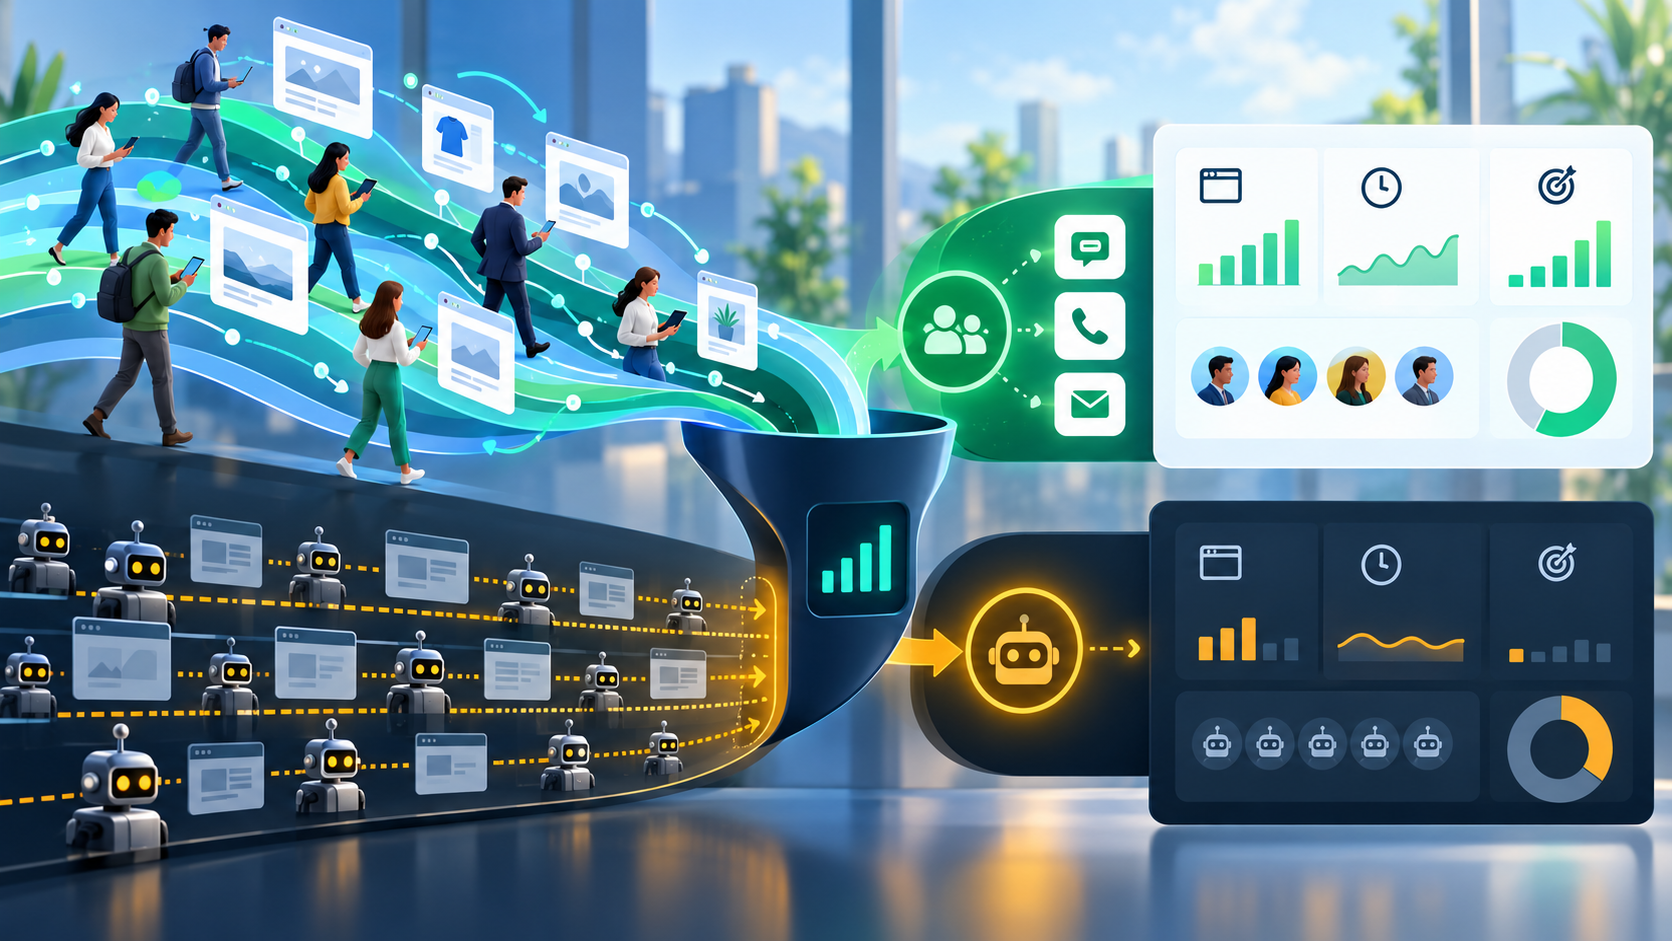
Vì sao số liệu bot trong log và analytics không giống nhau?
Log máy chủ ghi nhận request tới máy chủ hoặc CDN. Một crawler có thể tải HTML trực tiếp mà không chạy JavaScript analytics; khi đó request xuất hiện trong log nhưng không có session tương ứng trong GA4. Bot khác lại chạy trình duyệt tự động, kích hoạt thẻ analytics hoặc gửi sự kiện giả, nên vẫn có thể làm phình số liệu analytics.
GA4 tự động loại trừ bot và spider đã biết theo danh sách được duy trì cùng nghiên cứu của Google và IAB. Tuy nhiên, cơ chế này không có nghĩa mọi automation đều bị phát hiện, cũng không cho biết chính xác bao nhiêu sự kiện bị loại. Vì vậy, báo cáo analytics là một góc nhìn, không thay thế log CDN, log máy chủ hoặc dữ liệu chuyển đổi trong CRM.
Cũng cần phân biệt request với người dùng. Một bot tải HTML, CSS, ảnh và JavaScript có thể tạo nhiều request nhưng không tương đương nhiều khách truy cập. Ngược lại, một phiên truy cập có thể tạo rất nhiều event. Nếu đang so sánh số liệu giữa các hệ thống, hãy kiểm tra đúng đơn vị đo và khoảng thời gian.
Dấu hiệu traffic tự động cần điều tra
- Tần suất cao trong thời gian ngắn: cùng IP hoặc một nhóm IP gọi hàng trăm URL theo nhịp đều, kể cả ban đêm.
- Đường dẫn có quy luật: lần lượt dò nhiều URL không tồn tại, tham số lạ, trang đăng nhập, tìm kiếm nội bộ hoặc API.
- User-Agent không nhất quán: tự nhận là bot lớn nhưng IP không khớp hạ tầng công bố; hoặc nhiều request từ cùng nguồn thay đổi User-Agent liên tục.
- Thiếu hành vi trình duyệt: request chỉ tải HTML, không tải tài nguyên thường thấy, không có cookie hay tương tác tiếp theo. Đây là gợi ý, không phải bằng chứng riêng lẻ.
- Chỉ số analytics lệch bất thường: lượt xem tăng mạnh nhưng số người dùng, phiên có tương tác, biểu mẫu gửi thành công hoặc lead trong CRM không đổi.
- Tải hệ thống tăng: CPU, băng thông, lỗi 429/5xx hoặc thời gian phản hồi tăng cùng thời điểm có đợt request.
Không phải crawler nào cũng truy cập dày hoặc dễ nhận diện. Crawler hợp lệ có thể dùng IP phân tán; người dùng thật có thể lặp lại thao tác nhiều lần. Hãy đánh giá nhiều dấu hiệu cùng nhau và kiểm tra tác động thay vì chỉ đếm tên bot.
Cách kiểm tra từng lớp dữ liệu
Bước 1: Ghi nhận mốc thời gian và câu hỏi cần trả lời
So sánh ngày bắt đầu tăng với thời điểm đăng bài, gửi newsletter, chạy quảng cáo, thay đổi robots.txt, triển khai CDN hoặc phát hiện một trang được chia sẻ. Chọn khoảng thời gian trước và sau biến động có cùng độ dài. Ghi rõ cần biết điều gì: traffic có phải người dùng thật không, crawler nào gây tải, hay lead bị ảnh hưởng ra sao?
Bước 2: Xem tổng quan analytics
Trong GA4, so sánh người dùng, phiên, lượt xem, phiên có tương tác, sự kiện chuyển đổi, landing page, nguồn/medium, thiết bị và quốc gia theo ngày hoặc giờ. Tìm các trang có mức tăng khác thường và kiểm tra xem lượt xem có đi kèm sự kiện có ý nghĩa như gọi điện, gửi form, thêm sản phẩm vào giỏ hoặc yêu cầu báo giá hay không.
GA4 đã lọc bot đã biết tự động, nhưng doanh nghiệp vẫn nên xem chéo dữ liệu. Không tạo bộ lọc loại trừ ngay chỉ vì một nguồn lạ có thời gian tương tác thấp: nếu cài bộ lọc loại trừ dữ liệu ở cấp xử lý, dữ liệu bị loại có thể không khôi phục được. Khi còn điều tra, hãy bắt đầu bằng báo cáo hoặc phân đoạn để so sánh.
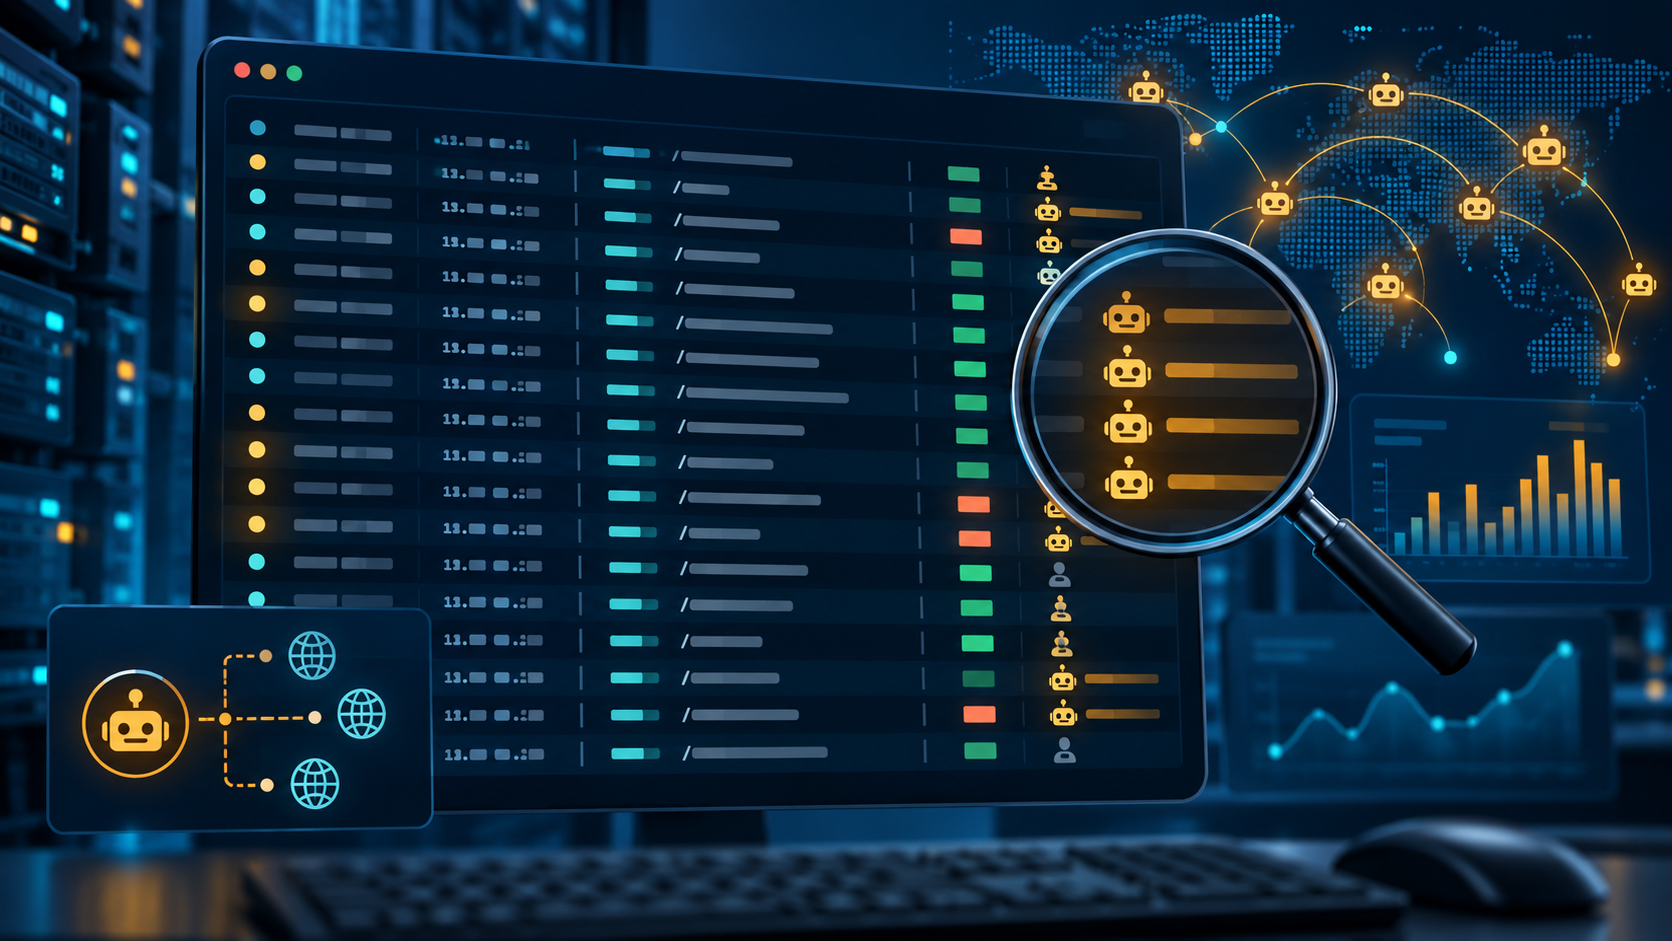
Bước 3: Đọc log CDN hoặc máy chủ
Nếu có Cloudflare, WAF hoặc log hosting, lọc khoảng thời gian tăng và nhóm theo IP, User-Agent, URL, mã trạng thái, quốc gia/ASN, referrer, phương thức HTTP và số request mỗi phút. Kiểm tra top IP có gọi nhiều trang liên tiếp không, có tập trung vào một endpoint không, và request nhận phản hồi 200, 404, 429 hay 5xx.
Kiểm tra header X-Forwarded-For hoặc trường IP client chỉ khi biết proxy/CDN của mình ghi chúng đáng tin cậy. Đừng lấy IP từ một header do client tự gửi nếu hệ thống không xác nhận hoặc ghi đè nó; kẻ gửi request có thể tự điền giá trị đó.
Bước 4: Xác minh bot tuyên bố là crawler
Với Googlebot, dùng quy trình reverse DNS rồi forward DNS hoặc danh sách IP chính thức của Google. Với bot của nhà cung cấp khác, kiểm tra tài liệu crawler của chính nhà cung cấp. Nếu không thể xác minh, ghi nhận là “chưa xác định” thay vì mặc định là bot tốt hay bot xấu. Hệ thống quản lý bot như Cloudflare có thể cung cấp nhãn bot đã xác minh hoặc điểm đánh giá request, tùy gói dịch vụ và cấu hình.
Bước 5: Đối chiếu lead và hoạt động thật
So sánh analytics với form submission đã lưu, cuộc gọi, đơn hàng, CRM và nhật ký chống spam. Xem liệu đợt tăng có tạo thêm liên hệ hợp lệ hay chỉ tạo event không có hồ sơ khách hàng. Nếu website có biểu mẫu, rà soát tốc độ gửi, nội dung trùng lặp, email lỗi định dạng và tỷ lệ spam. Một lượt truy cập không có chuyển đổi có thể đơn giản là khách đang tìm hiểu; lead tăng không đồng nghĩa mọi session khác đều là người thật.
Quy trình xử lý khi bot tăng bất thường
- Lưu lại bằng chứng: xuất mẫu log, khoảng thời gian, IP/ASN, User-Agent, URL và mã phản hồi trước khi thay đổi quy tắc.
- Phân loại mục đích: crawler tìm kiếm đã xác minh, bot AI tự nhận diện, công cụ giám sát, automation nội bộ, bot spam hoặc nguồn chưa rõ.
- Đánh giá rủi ro kinh doanh: bot có làm chậm website, gây lỗi, dò đăng nhập hoặc gửi form rác không? Nếu chỉ tải nội dung công khai ở nhịp hợp lý, tác động có thể chủ yếu nằm ở cách đọc báo cáo.
- Áp dụng biện pháp theo phạm vi: ưu tiên rate limit, challenge hoặc chặn endpoint bị lạm dụng thay vì chặn cả dải IP hoặc mọi User-Agent lạ. Robots.txt có thể nêu chỉ dẫn crawl cho bot tuân thủ, nhưng không phải tường lửa và không ngăn bot xấu bỏ qua chỉ dẫn.
- Kiểm tra lại sau thay đổi: theo dõi tải máy chủ, mã lỗi, log, sự kiện analytics và lead. Xác nhận quy tắc không ảnh hưởng crawler tìm kiếm hợp lệ, khách hàng thật hoặc tích hợp của doanh nghiệp.
Đối với Cloudflare Bot Management, trường “verified bot” và bot score có thể hỗ trợ phân loại request; chúng cần được hiểu trong phạm vi tính năng/gói dịch vụ cụ thể. Nhà cung cấp khuyên xem Bot Analytics trước, bắt đầu từ phạm vi nhỏ và tăng dần ngưỡng khi đã thấy tác động. Không nên lấy một điểm số hoặc nhãn tự động làm quyết định duy nhất cho mọi đường dẫn.
Checklist đọc báo cáo traffic bot
- Biến động bắt đầu lúc nào và có trùng với chiến dịch, bài đăng hoặc thay đổi kỹ thuật nào?
- Analytics tăng ở users, sessions, views hay events? Chỉ số nào thực sự thay đổi?
- Log cho thấy bao nhiêu request, từ IP/ASN và User-Agent nào, vào những URL gì?
- Bot có được xác minh bằng tài liệu chính thức, IP hoặc reverse DNS không?
- Tỷ lệ request 404, 429, 5xx và tải CPU/băng thông có tăng không?
- Lead, đơn hàng hoặc cuộc gọi hợp lệ trong CRM có tăng cùng chiều không?
- Quy tắc lọc/chặn có thể làm mất dữ liệu lịch sử hoặc ngăn bot tìm kiếm hợp lệ không?
Câu hỏi thường gặp
Traffic từ bot AI tăng có nghĩa là website được AI trích dẫn không?
Chưa thể kết luận như vậy. Bot có thể đang thu thập nội dung, kiểm tra URL hoặc truy cập do một người dùng yêu cầu. Muốn đánh giá nội dung có được dẫn nguồn hay không, cần kiểm tra referral, báo cáo giới thiệu từ nền tảng (nếu có), URL đích và bằng chứng nguồn cụ thể; log crawler chỉ cho biết có request.
GA4 đã lọc bot, có cần xem server log nữa không?
Có, nếu cần điều tra tải máy chủ, request không chạy JavaScript hoặc bot chưa nằm trong danh sách nhận diện của analytics. Hai nguồn trả lời những câu hỏi khác nhau: analytics phản ánh event được ghi nhận, còn log cho thấy request tới CDN hoặc máy chủ.
Có nên chặn tất cả bot AI trong robots.txt?
Chỉ nên đưa ra quyết định sau khi xác định mục tiêu của doanh nghiệp và bot cụ thể. Robots.txt là chỉ dẫn dành cho crawler tự nguyện tuân thủ, không phải cơ chế bảo mật. Cấu hình chặn nhầm có thể ảnh hưởng hoạt động khám phá nội dung; kiểm tra chính sách và xác minh hành vi trước khi áp dụng.
Kết luận
Traffic tăng bất thường cần được phân tích qua ba lớp: request trong log, event trong analytics và kết quả thật trong CRM hoặc hệ thống bán hàng. Tên User-Agent, địa lý, bounce hoặc thời gian trên trang chỉ là tín hiệu ban đầu. Hãy xác minh crawler, xem đường dẫn và nhịp truy cập, rồi đánh giá tải hệ thống và chất lượng lead trước khi lọc hay chặn.
Một quy trình ghi nhận mốc thời gian, đối chiếu dữ liệu và thử thay đổi theo phạm vi nhỏ giúp doanh nghiệp bảo vệ website mà vẫn giữ được dữ liệu đáng tin và khả năng truy cập của khách hàng thật.
Nguồn tham khảo
- Google Search Central: Googlebot và cách xác minh crawler
- Google Crawling Infrastructure: Verify requests from Google crawlers and fetchers
- Google Analytics Help: Known bot-traffic exclusion
- Google Analytics Help: Data filters
- Cloudflare: Bot scores
- Cloudflare: Bot Management variables and verified bot